Práctica local con datos ficticios. Pruebas de n8n 2.44.5 realizadas el 2 de noviembre de 2026. No requiere credenciales externas.
Una lista puede tener seis filas y solo dos contactos preparados para el siguiente paso. Borrar duplicados sin comprobar los datos puede esconder errores: un correo vacío se parece a otro correo vacío, y dos direcciones con espacios pueden parecer distintas aunque representen el mismo valor. Este proyecto aborda el lote completo y entrega tres listas separadas para decidir qué hacer después.
Qué resuelve y qué significa “válido” en esta práctica
El informe normaliza nombre y correo, comprueba que el nombre no esté vacío y aplica una comprobación sencilla del formato del email. Después separa duplicados por correo normalizado. “Válido” significa que supera estas reglas locales; no significa que el buzón exista, que la dirección pertenezca a esa persona ni que tengas permiso para enviarle mensajes.
La decisión de comparar el email en minúsculas es una política del ejercicio. Antes de aplicarla a una base real, define cómo identifica contactos tu sistema. Tampoco se intenta deducir qué persona hay detrás de dos correos distintos.
1. Prepara los cuatro nodos
Nivel intermedio. Necesitas n8n funcionando y conocimientos básicos de elementos, JSON y expresiones. La práctica se ejecuta manualmente, con datos ficticios y sin conectar cuentas externas. No escribe en un CRM, no manda correos y no modifica un inventario real.
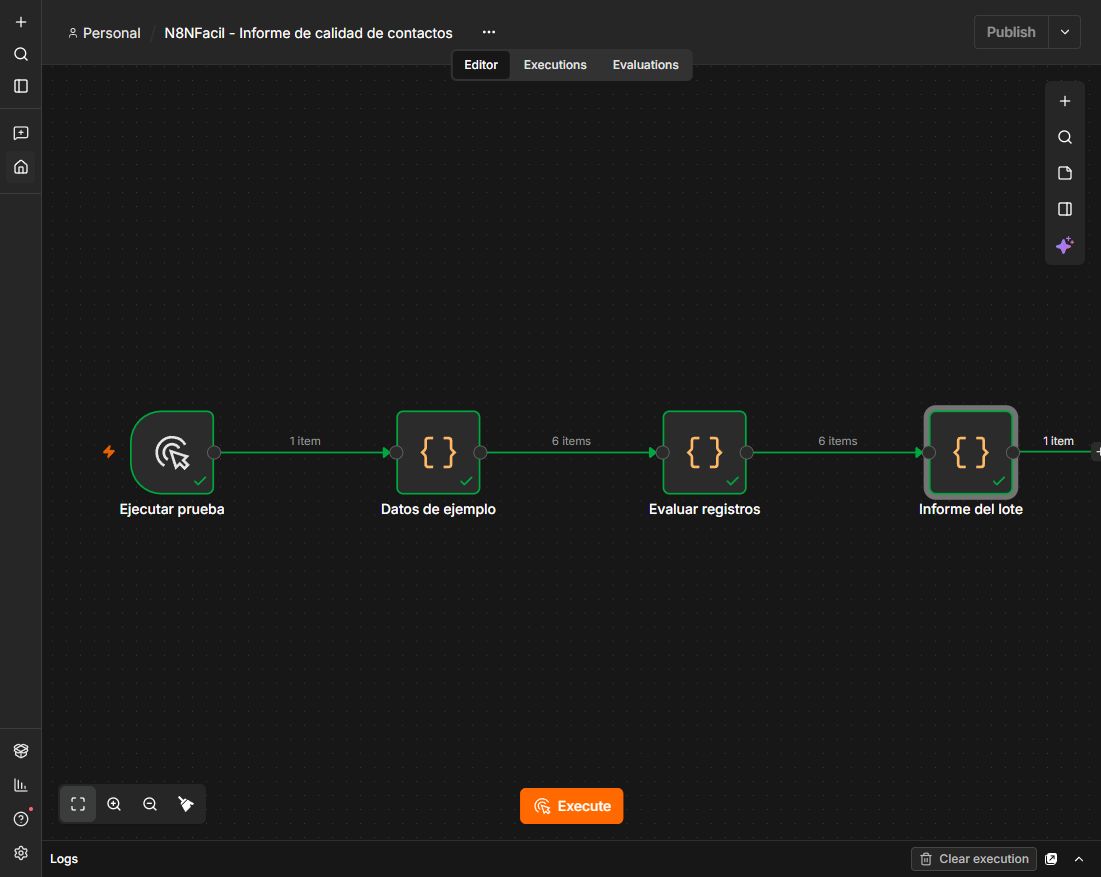
Crea un workflow vacío. Añade Manual Trigger y tres nodos Code conectados en este orden: Ejecutar prueba → Datos de ejemplo → Evaluar registros → Informe del lote. En los tres nodos Code selecciona JavaScript y Run Once for All Items. Este modo permite comparar un lote y construir un informe único. Los nombres son etiquetas del proyecto: renómbralos para seguir las explicaciones.
Hemos elegido Code para mantener visibles las reglas de validación y conservar también los registros problemáticos. No es la única implementación posible: una combinación de Edit Fields, IF, Remove Duplicates y Aggregate puede repartir el trabajo entre más nodos. Aquí el objetivo es comprender una política completa antes de conectar servicios.
2. Introduce un lote con problemas diferentes
Pega este código en Datos de ejemplo. No arregles los espacios ni añadas el correo que falta: necesitamos conservar esos casos para observar la clasificación.
return [
  {
    "id": "C1",
    "nombre": " Ana ",
    "email": " ANA@EXAMPLE.COM "
  },
  {
    "id": "C2",
    "nombre": "Ana repetida",
    "email": "ana@example.com"
  },
  {
    "id": "C3",
    "nombre": "Luis",
    "email": "luis@example.com"
  },
  {
    "id": "C4",
    "nombre": "Sin correo"
  },
  {
    "id": "C5",
    "nombre": "Correo incompleto",
    "email": "ana@"
  },
  {
    "id": "C6",
    "nombre": "   ",
    "email": "otra@example.com"
  }
].map(json => ({json}));
Cada entrada tiene un id que permite localizarla sin depender del nombre. El caso C2 comparte correo con C1, C4 no trae email, C5 contiene una dirección incompleta y C6 tiene un nombre formado por espacios. Una automatización útil debe explicar qué ocurrió con todos ellos.
3. Normaliza, comprueba y clasifica
Pega lo siguiente en Evaluar registros. El Set vistos se crea al empezar esta ejecución y solo recibe correos de registros que ya han superado las comprobaciones. Así, una fila incompleta no reserva un correo e impide aceptar otra fila posterior correcta.
const vistos = new Set();
return $input.all().map(item => {
  const original = item.json;
  const nombre = typeof original.nombre === 'string' ? original.nombre.trim() : '';
  const email = typeof original.email === 'string' ? original.email.trim().toLowerCase() : '';
  const motivos = [];
  if (!nombre) motivos.push('nombre_ausente');
  if (!/^[^\s@]+@[^\s@]+\.[^\s@]+$/.test(email)) motivos.push('formato_email');
  let estado = 'valido';
  if (motivos.length) estado = 'revisar';
  else if (vistos.has(email)) estado = 'duplicado';
  else vistos.add(email);
  return {json: {id: original.id, nombre, email, estado, motivos}};
});
El orden de las reglas importa: primero revisamos nombre y formato; después buscamos repetición. La primera fila válida con ese correo queda como válida y las siguientes como duplicadas. No fusionamos nombres ni elegimos automáticamente “la ficha más reciente”, porque no tenemos una fecha fiable para hacerlo.
La expresión regular es deliberadamente sencilla. Descarta errores habituales como un número usado como correo o una dirección sin parte de dominio, pero no implementa toda la especificación del correo electrónico. El array motivos conserva una explicación que podría mostrarse en una revisión manual.
4. Genera un informe sin perder filas
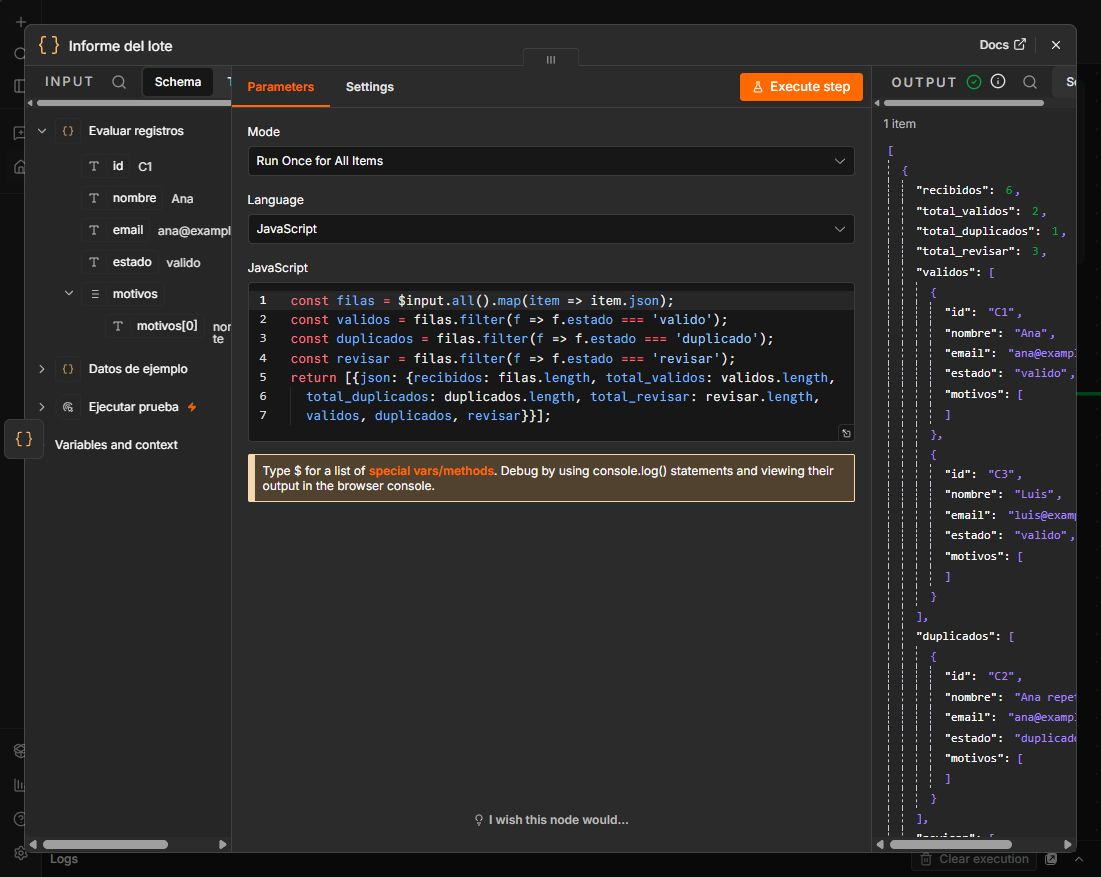
En Informe del lote utiliza este código. La salida es un elemento con contadores y listas; no seis elementos separados. Un consumidor posterior tendría que seleccionar una lista y convertir sus entradas en elementos si necesita procesarlas una a una.
const filas = $input.all().map(item => item.json);
const validos = filas.filter(f => f.estado === 'valido');
const duplicados = filas.filter(f => f.estado === 'duplicado');
const revisar = filas.filter(f => f.estado === 'revisar');
return [{json: {recibidos: filas.length, total_validos: validos.length,
  total_duplicados: duplicados.length, total_revisar: revisar.length,
  validos, duplicados, revisar}}];
5. Comprueba los resultados antes de conectar un destino
| Grupo | Resultado del lote de ejemplo |
|---|---|
| Recibidos | 6 |
| Válidos | 2: C1 y C3 |
| Duplicados | 1: C2 |
| Para revisar | 3: C4, C5 y C6 |
Comprueba la igualdad 6 = 2 + 1 + 3. Esta conciliación ayuda a detectar registros perdidos entre etapas. Abre validos y verifica que el correo de Ana sale como ana@example.com. En duplicados debe figurar C2; no basta con que el contador diga uno.
Casos límite que probamos
También ejecutamos una variante con un primer registro sin nombre, otro posterior correcto con el mismo correo, un duplicado normalizado y un email numérico. El resultado fue un válido, un duplicado y dos para revisar. El contacto correcto siguió siendo aceptado: el incompleto anterior no había reservado su correo. Al repetir el lote original se obtuvo el mismo informe, confirmando que el Set no conserva historial entre ejecuciones.
Lo que este proyecto no resuelve
Si el mismo contacto vuelve mañana, se volverá a considerar válido dentro del nuevo lote. Para evitar duplicados entre ejecuciones necesitas un destino persistente y una clave estable; no uses una variable en memoria como si fuera una base de datos. Además, resolver conflictos entre nombres, fechas y fuentes exige una política de actualización explícita.
Un lote sin elementos puede detener el recorrido antes del informe: aquí no hemos verificado un origen vacío dentro de n8n. Tampoco se ha medido rendimiento con miles de registros. No conectes el resultado a un envío masivo hasta revisar permisos, bajas, errores del proveedor y tratamiento de datos personales.
Cómo encaja con los tutoriales anteriores
Si la normalización te resulta nueva, empieza por limpiar datos con Edit Fields. Para comparar enfoques, revisa Remove Duplicates. Un posible siguiente paso es recibir los registros desde un Webhook, manteniendo separada la recepción de la validación. Este descargable todavía utiliza el disparador manual.
Consulta la documentación oficial del nodo Code para sus modos de ejecución y la estructura de datos de n8n para entender los objetos con una propiedad json. Los códigos de esta guía son propios del proyecto.
Descarga el proyecto para repetir la práctica
Descargar workflow y archivos de práctica en ZIP. Incluye el JSON de n8n, los códigos de los nodos, instrucciones y resultados de las pruebas. No incluye la base de datos de la instalación ni credenciales.
Autor: Javier Fernández. Soy estudiante y comparto lo que aprendo con proyectos de práctica. Las pruebas descritas utilizan datos ficticios. Conoce el proyecto o comunica un error indicando el paso y la versión de n8n.
Leave a Reply